论文名称:YOLOv4: Optimal Speed and Accuracy of Object Detection
论文下载地址:https://arxiv.org/abs/2004.10934
文章目录
0 前言
YOLOv4是2020年
Alexey Bochkovskiy
等人发表在CVPR上的一篇文章,并不是
Darknet
的原始作者
Joseph Redmon
发表的,但这个工作已经被
Joseph Redmon
大佬认可了。之前我们有聊过
YOLOv1
~
YOLOv3
以及
Ultralytics
版的
YOLOv3 SPP
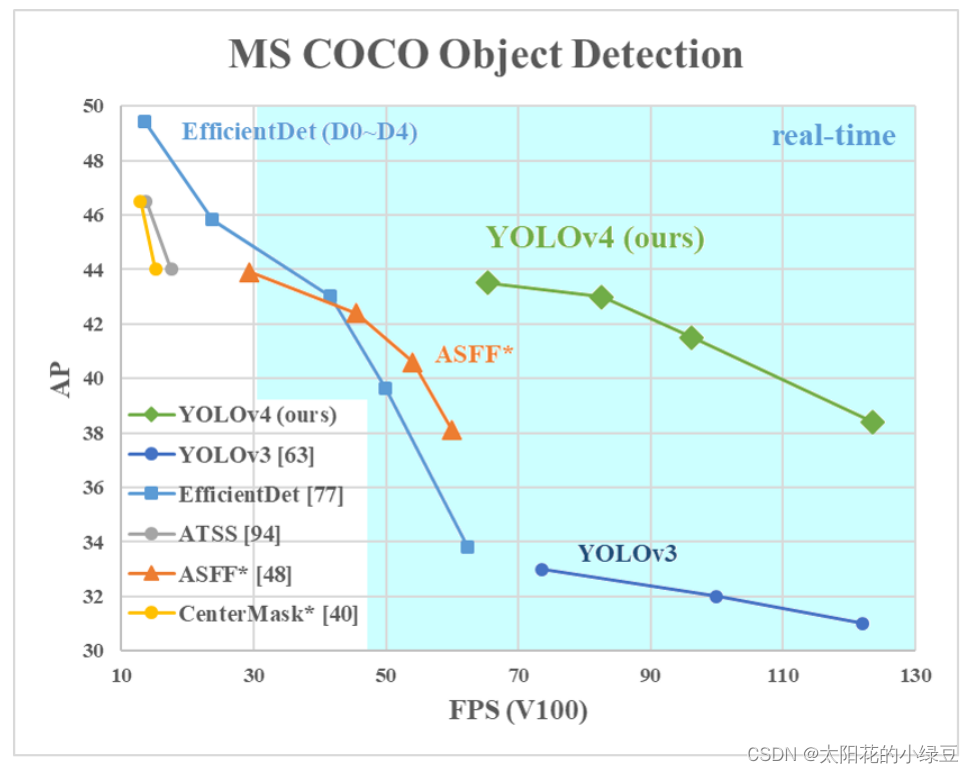
网络结构,如果不了解的可以参考之前的视频,YOLO系列网络详解。如果将
YOLOv4
和原始的
YOLOv3
相比效果确实有很大的提升,但和
Ultralytics
版的
YOLOv3 SPP
相比提升确实不大,但毕竟
Ultralytics
的
YOLOv3 SPP
以及
YOLOv5
都没有发表过正式的文章,所以不太好讲。所以今天还是先简单聊聊
Alexey Bochkovskiy
的
YOLOv4
。
1 YOLOv4中的亮点
如果之前有阅读过
YOLOv4
这篇论文的小伙伴,你会发现作者就是把当年所有的常用技术罗列了一遍,然后做了一堆消融实验。实验过程及结果写的还是很详细的,但对我个人而言感觉有点杂乱,没能很好的突出重点。如果大家对实验不敢兴趣的话,直接从论文
3.4
章节往后看就行了。
1.1 网络结构
在论文
3.4
章节中介绍了
YOLOv4
网络的具体结构:
- Backbone:
CSPDarknet53 - Neck:
SPP,PAN - Head:
YOLOv3
相比之前的
YOLOv3
,改进了下Backbone,在
Darknet53
中引入了
CSP
模块(来自
CSPNet
)。在Neck部分,采用了
SPP
模块(
Ultralytics
版的
YOLOv3 SPP
就使用到了)以及
PAN
模块(来自
PANet
)。Head部分没变还是原来的检测头。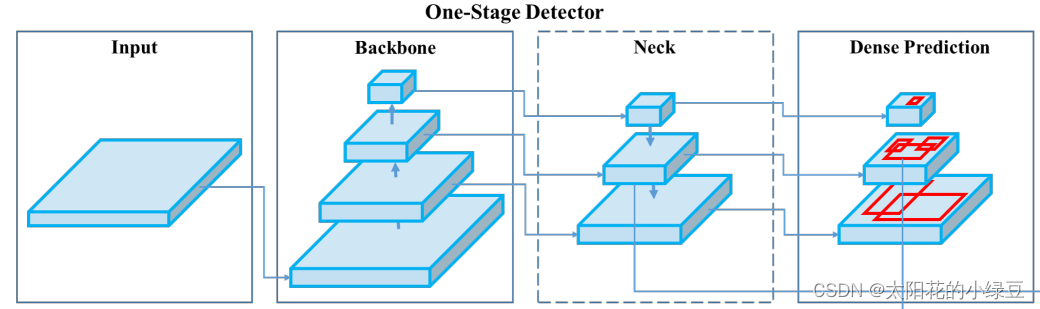 关于
CSPDarnet53
,后面有专门的章节讲解,这里暂时跳过。关于
SPP
(
Spatial Pyramid Pooling
)模块之前讲YOLO系列网络详解时详细介绍过,
SPP
就是将特征层分别通过一个池化核大小为
5x5
、
9x9
、
13x13
的最大池化层,然后在通道方向进行concat拼接在做进一步融合,这样能够在一定程度上解决目标多尺度问题,如下图所示。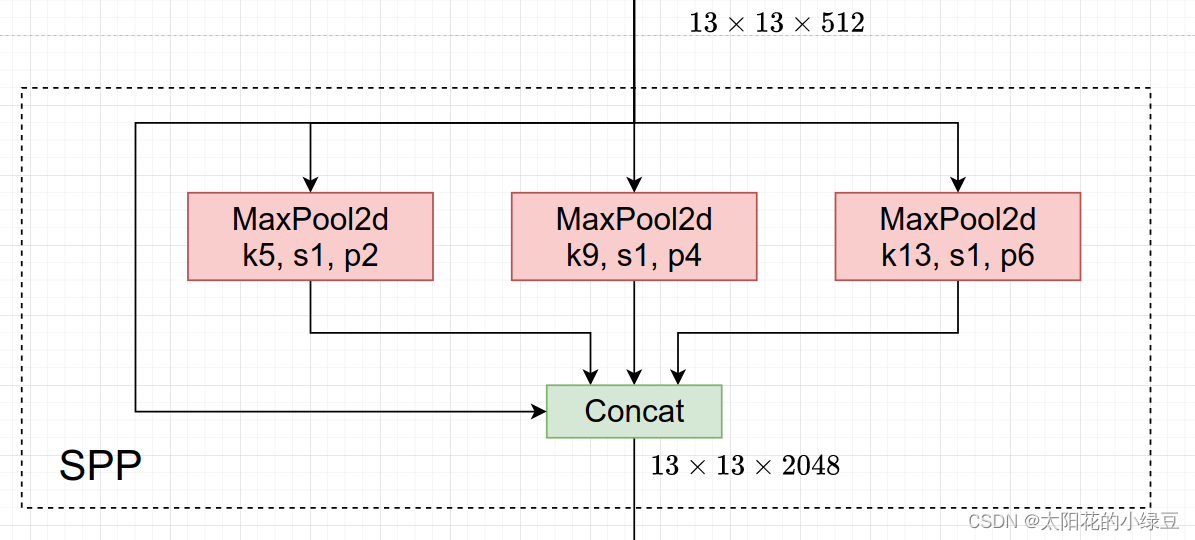
PAN
(
Path Aggregation Network
)结构其实就是在
FPN
(从顶到底信息融合)的基础上加上了从底到顶的信息融合,如下图(b)所示。

但
YOLOv4
的
PAN
结构和原始论文的融合方式又略有差异,如下图所示。图(a)是原始论文中的融合方式,即特征层之间融合时是直接通过相加的方式进行融合的,但在
YOLOv4
中是通过在通道方向
Concat
拼接的方式进行融合的。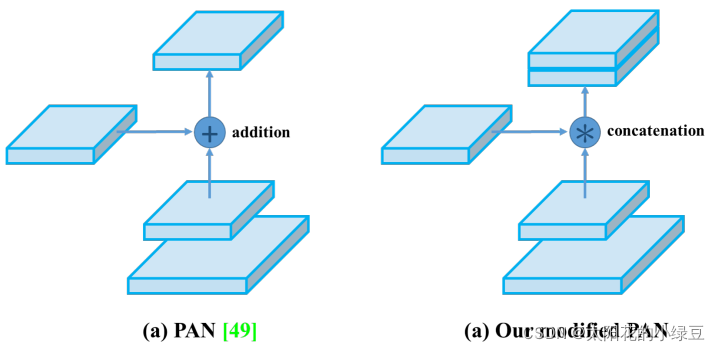
1.2 优化策略
有关训练Backbone时采用的优化策略就不讲了有兴趣自己看下论文的
4.2
章节,这里直接讲下训练检测器时作者采用的一些方法。在论文
4.3
章节,作者也罗列了一堆方法,并做了部分消融实验。这里我只介绍确实在代码中有使用到的一些方法。
1.2.1 Eliminate grid sensitivity
在原来
YOLOv3
中,关于计算预测的目标中心坐标计算公式是:
b
x
=
σ
(
t
x
)
+
c
x
b
y
=
σ
(
t
y
)
+
c
y
b_x = \sigma(t_x) + c_x \\ b_y = \sigma(t_y) + c_y
bx=σ(tx)+cxby=σ(ty)+cy
其中:
t x t_x tx是网络预测的目标中心 x x x坐标偏移量(相对于网格的左上角)t y t_y ty是网络预测的目标中心 y y y坐标偏移量(相对于网格的左上角)c x c_x cx是对应网格左上角的 x x x坐标c y c_y cy是对应网格左上角的 y y y坐标σ \sigma σ是```sigmoid```激活函数,将预测的偏移量限制在0到1之间,即预测的中心点不会超出对应网格区域
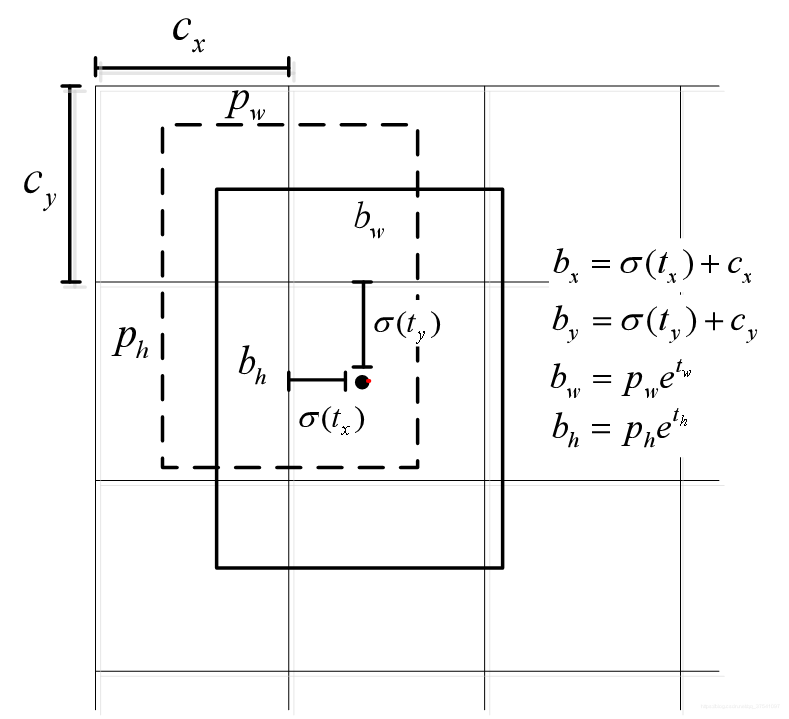
但在
YOLOv4
的论文中作者认为这样做不太合理,比如当真实目标中心点非常靠近网格的左上角点(
σ
(
t
x
)
\sigma(t_x)
σ(tx)和
σ
(
t
y
)
\sigma(t_y)
σ(ty)应该趋近与0)或者右下角点(
σ
(
t
x
)
\sigma(t_x)
σ(tx)和
σ
(
t
y
)
\sigma(t_y)
σ(ty)应该趋近与1)时,网络的预测值需要非常小或者非常大时才能取到,而这种很极端的值网络一般无法达到。为了解决这个问题,作者引入了一个大于1的缩放系数(
s
c
a
l
e
x
y
{\rm scale}_{xy}
scalexy):
b
x
=
(
σ
(
t
x
)
⋅
s
c
a
l
e
x
y
−
s
c
a
l
e
x
y
−
1
2
)
+
c
x
b
y
=
(
σ
(
t
y
)
⋅
s
c
a
l
e
x
y
−
s
c
a
l
e
x
y
−
1
2
)
+
c
y
b_x = (\sigma(t_x) \cdot {\rm scale}_{xy} - \frac{{\rm scale}_{xy}-1}{2}) + c_x \\ b_y = (\sigma(t_y) \cdot {\rm scale}_{xy} - \frac{{\rm scale}_{xy}-1}{2})+ c_y
bx=(σ(tx)⋅scalexy−2scalexy−1)+cxby=(σ(ty)⋅scalexy−2scalexy−1)+cy
通过引入这个系数,网络的预测值能够很容易达到0或者1,我看现在比较新的实现方法包括
YOLOv5
都将
s
c
a
l
e
x
y
{\rm scale}_{xy}
scalexy设置2,即:
b
x
=
(
σ
(
t
x
)
⋅
2
−
0.5
)
+
c
x
b
y
=
(
σ
(
t
y
)
⋅
2
−
0.5
)
+
c
y
b_x = (\sigma(t_x) \cdot 2 - 0.5) + c_x \\ b_y = (\sigma(t_y) \cdot 2 - 0.5) + c_y
bx=(σ(tx)⋅2−0.5)+cxby=(σ(ty)⋅2−0.5)+cy
下面是我绘制的
    y


    =


    σ


    (


    x


    )


   y = \sigma(x)


y=σ(x)(sigma)和


    y


    =


    σ


    (


    x


    )


    ⋅


    2


    −


    0.5


   y = \sigma(x) \cdot 2 - 0.5


y=σ(x)⋅2−0.5(scale)的曲线,很明显通过引入缩放系数scale以后,


    x


   x


x在同样的区间内,


    y


   y


y的取值范围更大,或者说


    y


   y


y对


    x


   x


x更敏感了。并且偏移的范围由原来的


    (


    0


    ,


    1


    )


   (0, 1)


(0,1)调整到了


    (


    −


    0.5


    ,


    1.5


    )


   (-0.5, 1.5)


(−0.5,1.5)。

1.2.2 Mosaic data augmentation
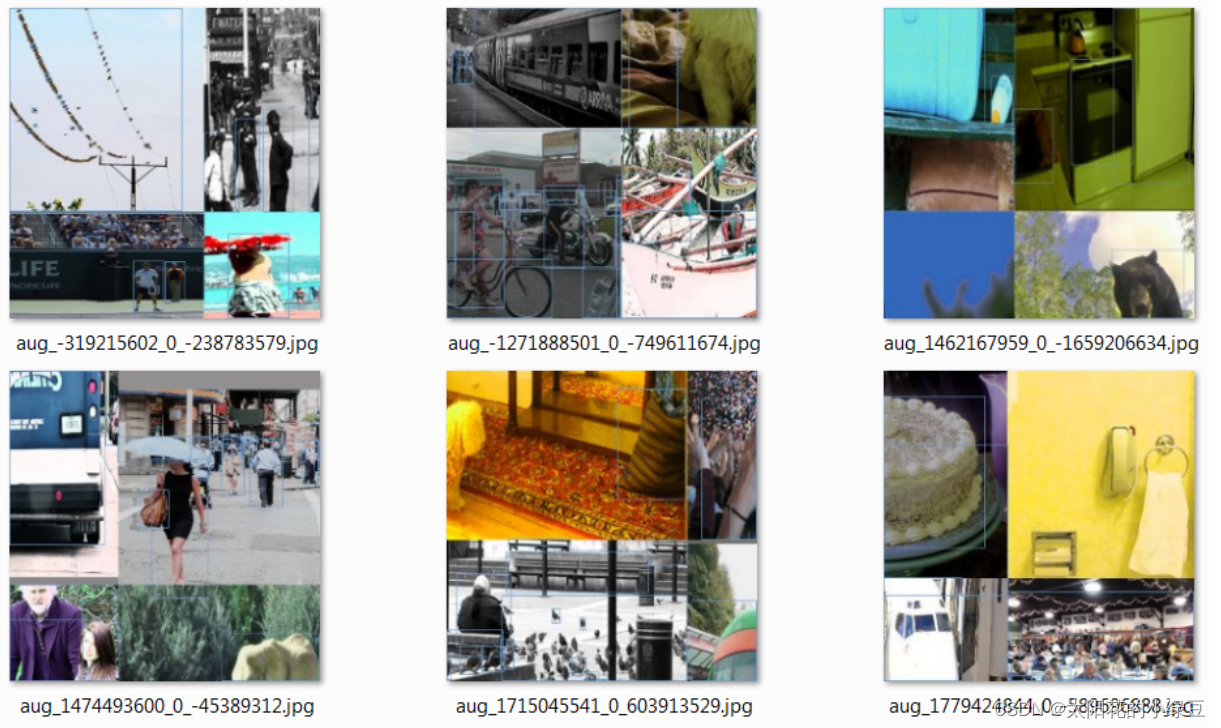
在数据预处理时将四张图片拼接成一张图片,增加学习样本的多样性,之前在YOLO系列网络详解P4中讲过,这里不在赘述。
1.2.3 IoU threshold(正样本匹配)
在
YOLOv3
中针对每一个GT都只分配了一个Anchor。但在
YOLOv4
包括之前讲过的
YOLOv3 SPP
以及
YOLOv5
中一个GT可以同时分配给多个Anchor,它们是直接使用Anchor模板(注意不是绘制在图上的每个Anchor,不要把Anchor模板和Anchor弄混了)与GT Boxes进行粗略匹配,然后在定位到对应Anchor的位置。
首先回顾下之前在讲
YOLOv3 SPP
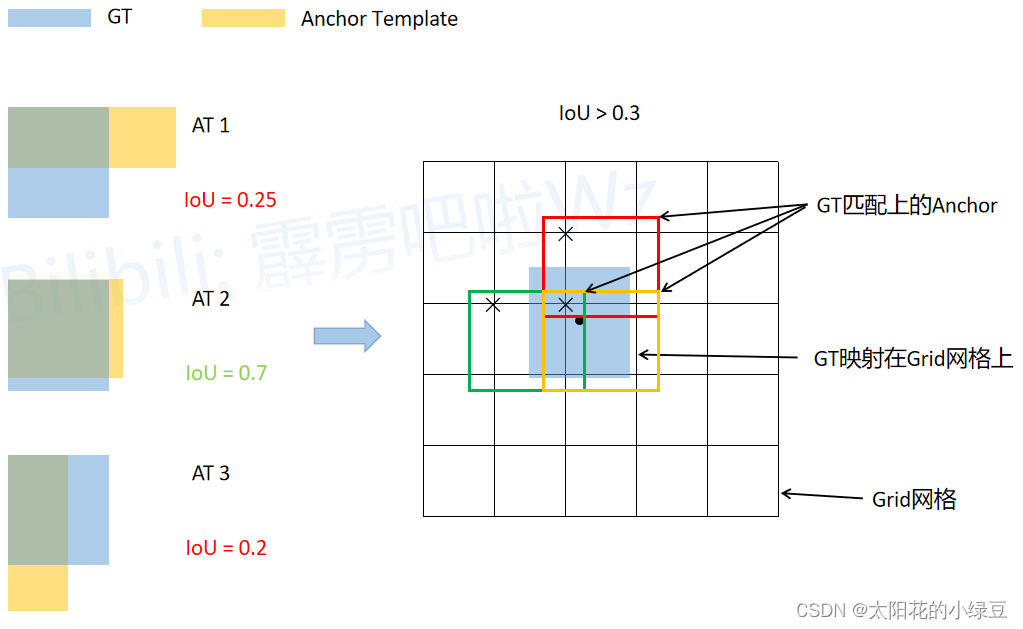
源码解析时提到的正样本匹配过程。流程大致如下图所示:比如说针对某个预测特征层采用如下三种Anchor模板
AT 1
、
AT 2
、
AT 3

- 将每个GT Boxes与每个Anchor模板进行匹配(这里直接将GT和Anchor模板左上角对齐,然后计算IoU)
- 如果GT与某个Anchor模板的IoU大于给定的阈值,则将GT分配给该Anchor模板,如图中的
AT 2 - 将GT投影到对应预测特征层上,根据GT的中心点定位到对应
cell(图中黑色的 × \times ×表示cell的左上角) - 将匹配上的Anchor模板(
AT 2)以对应cell的中心绘制得到Anchor,则该Anchor为正样本
但在
YOLOv4
以及
YOLOv5
中关于匹配正样本的方法又有些许不同。主要原因在于
1.2.1 Eliminate grid sensitivity
中提到的缩放因子
s
c
a
l
e
x
y
scale_{xy}
scalexy,通过缩放后网络预测中心点的偏移范围已经从原来的
(
0
,
1
)
(0, 1)
(0,1)调整到了
(
−
0.5
,
1.5
)
(-0.5, 1.5)
(−0.5,1.5)。所以对于同一个GT Boxes可以分配给更多的Anchor,即正样本的数量更多了。如下图所示:
- 将每个GT Boxes与每个Anchor模板进行匹配(这里直接将GT和Anchor模板左上角对齐,然后计算IoU)
- 如果GT与某个Anchor模板的IoU大于给定的阈值,则将GT分配给该Anchor模板,如图中的
AT 2 - 将GT投影到对应预测特征层上,根据GT的中心点定位到对应
cell(注意图中有三个对应的cell) - 将匹配上的Anchor模板(
AT 2)以每个cell为中心绘制得到Anchor,则这些Anchor都为正样本(注意这里有橙色、红色以及绿色三个Anchor)
这里为什么会匹配到三个Anchor,这里简单做下解释(这里是通过分析
ultralytics
的
YOLOv5
源码得到的)。刚刚说了网络预测中心点的偏移范围已经调整到了
    (


    −


    0.5


    ,


    1.5


    )


   (-0.5, 1.5)


(−0.5,1.5)。后续补齐
在
YOLOv4
中IoU的阈值设置的是
0.213
.
1.2.4 Optimizer Anchors
在
YOLOv3
中使用anchor模板是:
目标类型Anchors模板小尺度
       (


       10


       ×


       13


       )


       ,


       (


       16


       ×


       30


       )


       ,


       (


       33


       ×


       23


       )


      (10 \times 13), (16 \times 30), (33 \times 23)


   (10×13),(16×30),(33×23)中尺度


       (


       30


       ×


       61


       )


       ,


       (


       62


       ×


       45


       )


       ,


       (


       59


       ×


       119


       )


      (30 \times 61), (62 \times 45), (59 \times 119)


   (30×61),(62×45),(59×119)大尺度


       (


       116


       ×


       90


       )


       ,


       (


       156


       ×


       198


       )


       ,


       (


       373


       ×


       326


       )


      (116 \times 90), (156 \times 198), (373 \times 326)


   (116×90),(156×198),(373×326)
在
YOLOv4
中作者针对
    512


    ×


    512


   512 \times 512


512×512尺度采用的anchor模板是:
目标类型Anchors模板小尺度
       (


       12


       ×


       16


       )


       ,


       (


       19


       ×


       36


       )


       ,


       (


       40


       ×


       28


       )


      (12 \times 16), (19 \times 36), (40 \times 28)


   (12×16),(19×36),(40×28)中尺度


       (


       36


       ×


       75


       )


       ,


       (


       76


       ×


       55


       )


       ,


       (


       72


       ×


       146


       )


      (36 \times 75), (76 \times 55), (72 \times 146)


   (36×75),(76×55),(72×146)大尺度


       (


       142


       ×


       110


       )


       ,


       (


       192


       ×


       243


       )


       ,


       (


       459


       ×


       401


       )


      (142 \times 110), (192 \times 243), (459 \times 401)


   (142×110),(192×243),(459×401)
1.2.5 CIoU(定位损失)
在
YOLOv3
中定位损失采用的是MSE损失,但在
YOLOv4
中作者采用的是
CIoU
损失。之前在YOLO系列网络详解P4中很详细的讲解过
IoU Loss
,
DIoU Loss
以及
CIoU Loss
,这里不在赘述。

2 CSPDarknet53网络结构
CSPDarknet53
就是将
CSP
结构融入了
Darknet53
中。
CSP
结构是在
CSPNet
(
Cross Stage Partial Network
)论文中提出的,
CSPNet
作者说在目标检测任务中使用
CSP
结构有如下好处:
- Strengthening learning ability of a CNN
- Removing computational bottlenecks
- Reducing memory costs
即减少网络的计算量以及对显存的占用,同时保证网络的能力不变或者略微提升。
CSP
结构的思想参考原论文中绘制的
CSPDenseNet
,进入每个
stage
(一般在下采样后)先将数据划分成俩部分,如下图所示的
Part1
和
Part2
。但具体怎么划分呢,在
CSPNet
中是直接按照通道均分,但在
YOLOv4
网络中是通过两个
1x1
的卷积层来实现的。在
Part2
后跟一堆
Blocks
然后在通过
1x1
的卷积层(图中的
Transition
),接着将两个分支的信息在通道方向进行Concat拼接,最后再通过
1x1
的卷积层进一步融合(图中的
Transition
)。

接下来详细分析下
CSPDarknet53
网络的结构,下图是我根据开源仓库https://github.com/Tianxiaomo/pytorch-YOLOv4中代码绘制的
CSPDarknet53
详细结构(以输入图片大小为
    416


    ×


    416


    ×


    3


   416 \times 416 \times 3


416×416×3为例),图中:
k k k代表卷积核的大小s s s代表步距c c c代表通过该模块输出的特征层channels- 注意,
CSPDarknet53Backbone中所有的激活函数都是Mish激活函数

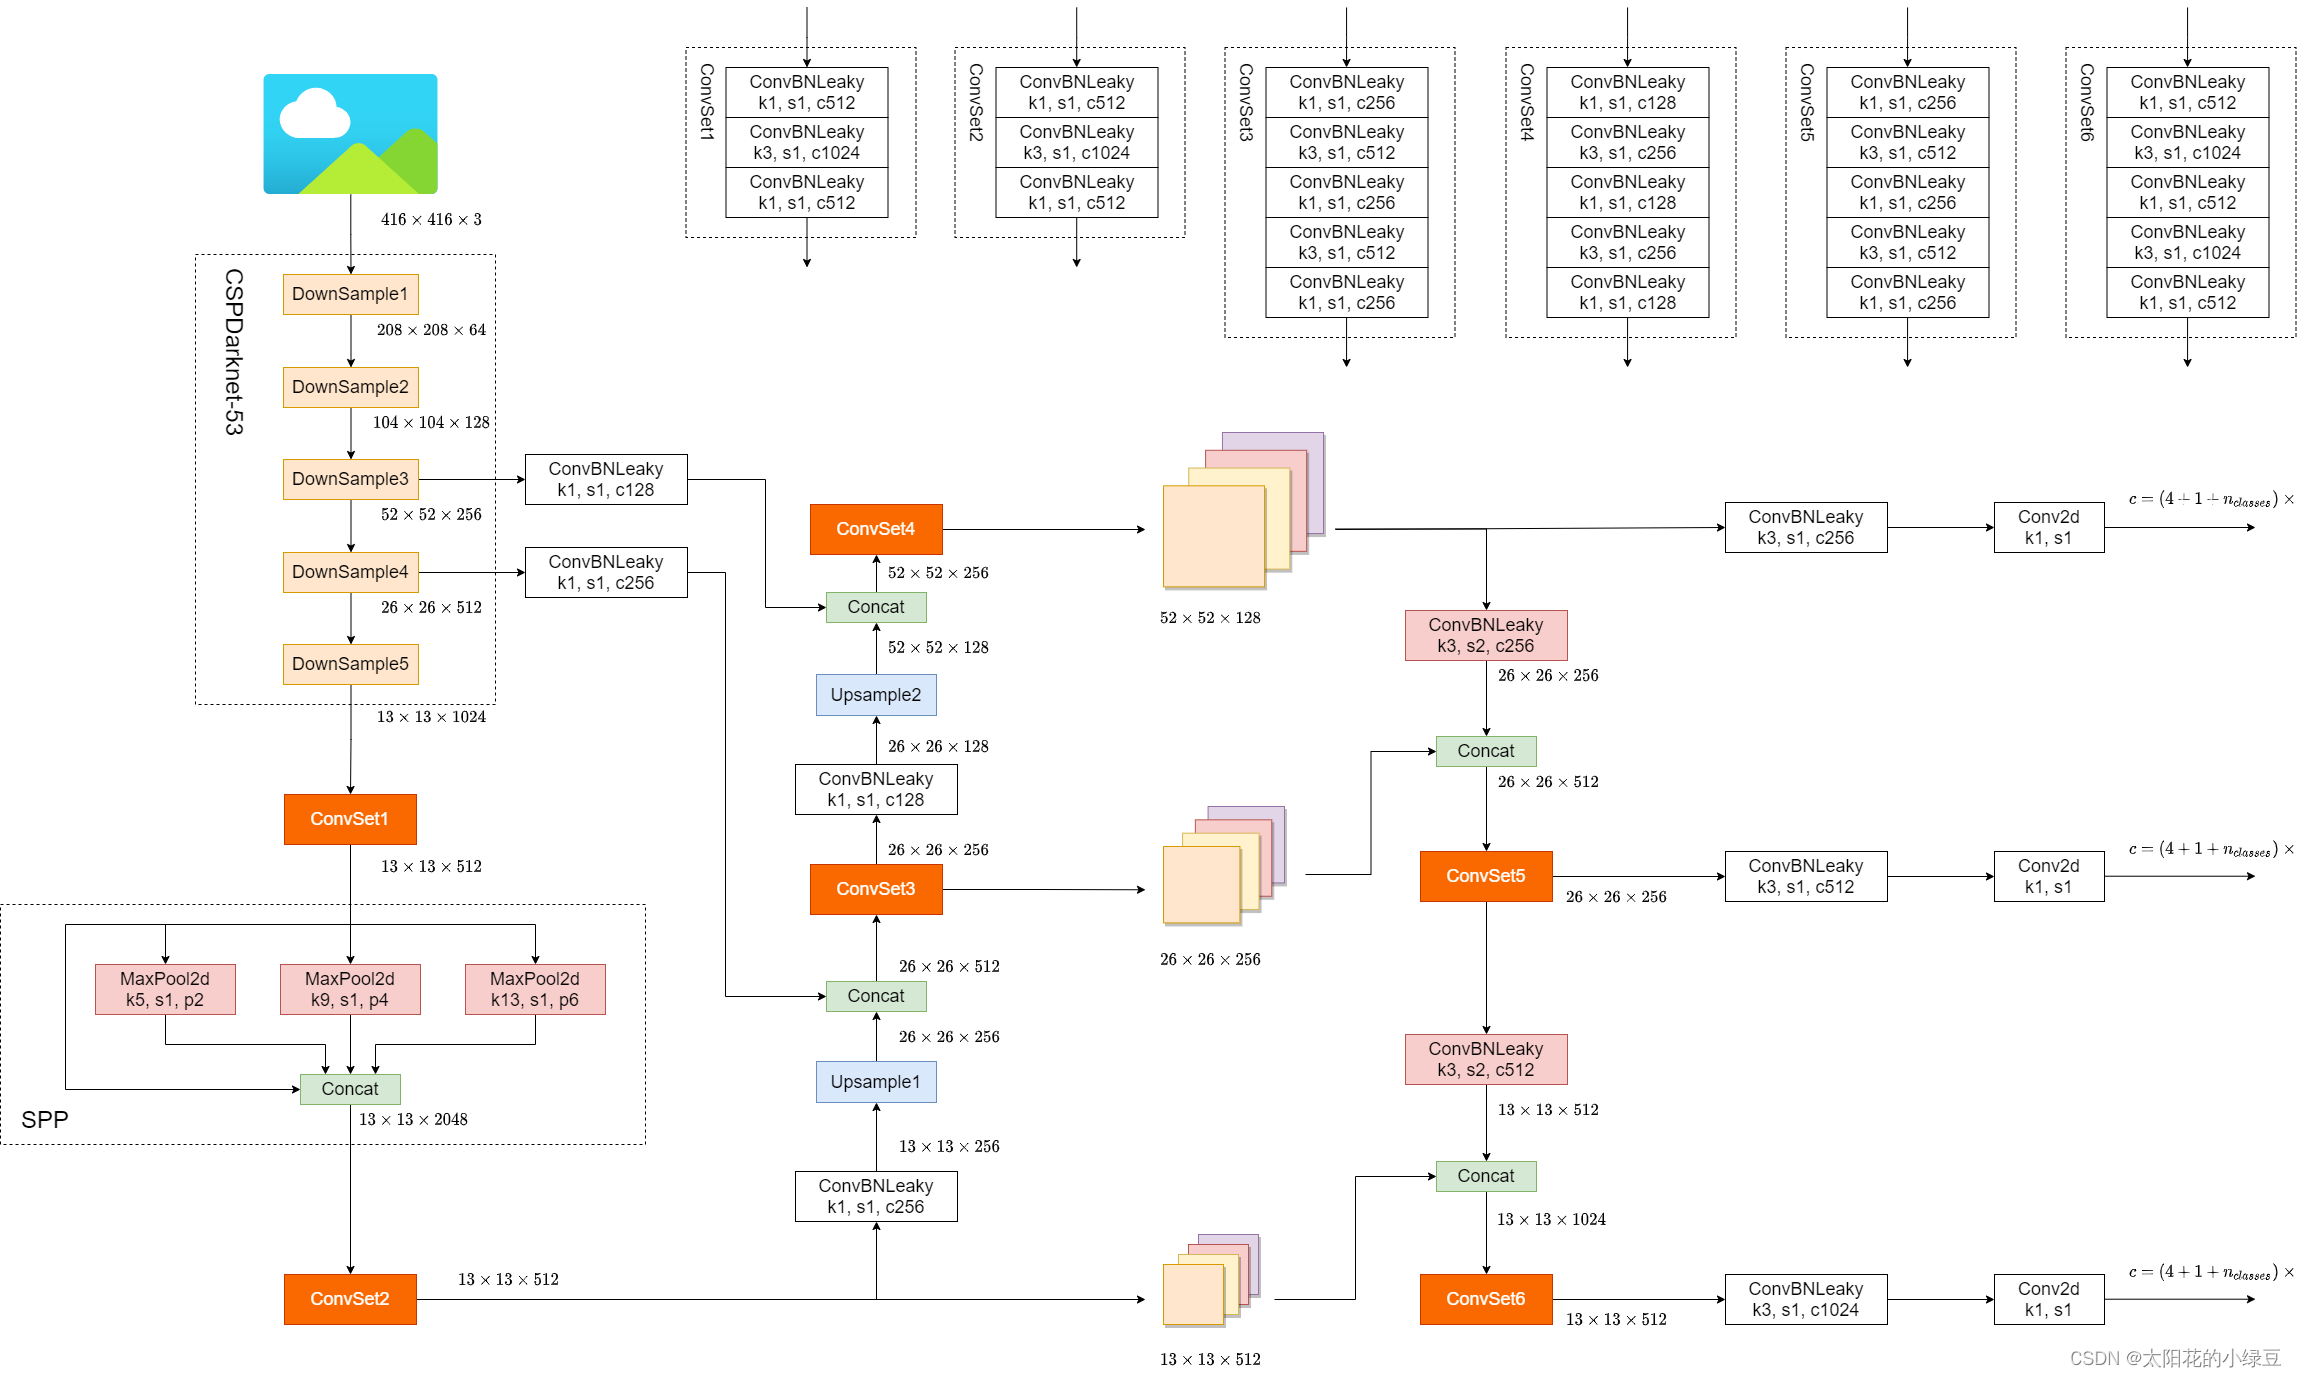
3 YOLOv4网络结构
下图是我绘制的
YOLOv4
网络的详细结构,大家在搭建或者学习过程中可以进行参考。
版权归原作者 太阳花的小绿豆 所有, 如有侵权,请联系我们删除。