官方源码仓库:https://github.com/ultralytics/yolov5
文章下载地址:没有
文章目录
0 前言
在前面我们已经介绍过了YOLOv1~v4的网络的结构,今天接着上次的YOLOv4再来聊聊YOLOv5,如果还不了解YOLOv4的可以参考之前的博文。YOLOv5项目的作者是
Glenn Jocher
并不是原
Darknet
项目的作者
Joseph Redmon
。并且这个项目至今都没有发表过正式的论文。之前翻阅该项目的
issue
时,发现有很多人问过这个问题,有兴趣的可以翻翻这个issue #1333。作者当时也有说准备在2021年的12月1号之前发表,并承诺如果到时候没有发表就吃掉自己的帽子。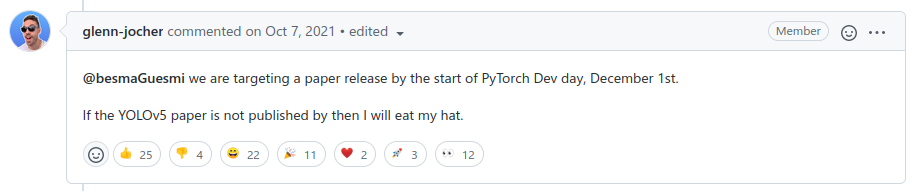
(⊙o⊙)…,emmm,但这都2022年了,也不知道他的帽子是啥味儿。过了他承诺的发表期限后,很多人还去该
issue
下表示"关怀",问啥时候吃帽子,下面这位大哥给我整笑了。
本来
Glenn Jocher
是准备要发表论文的,但至于为啥没发成作者并没有给出原因。我个人的猜测是自从YOLOv4发表后,有很多人想发这方面的文章,然后在YOLOv4上进行改动,改动过程中肯定有人把YOLOv5仓库里的一些技术拿去用了(YOLOv4论文4月出的,YOLOv5仓库5月就有了)。大家改完后发了一堆文章,那么YOLOv5的技术就被零零散散的发表到各个文章中去了。
Glenn Jocher
一看,这也太卷了吧,你们都把我技术写了,那我还写个锤子,直接撂挑子不干了。
当然以上都是我个人yy哈,回归正题,YOLOv5仓库是在
2020-05-18
创建的,到今天已经迭代了很多个大版本了,现在(
2022-3-19
)已经迭代到
v6.1
了。所以本篇博文讲的内容是针对
v6.1
的,大家阅读的时候注意看下版本号,不同的版本内容会略有不同。前几天我在YOLOv5项目中向作者提了一个issue #6998,主要是根据当前的源码做了一个简单的总结,然后想让作者帮忙看看总结的内容是否有误,根据作者的反馈应该是没啥问题的,所以今天就来谈谈我个人的见解。下表是当前(
v6.1
)官网贴出的关于不同大小模型以及输入尺度对应的
mAP
、推理速度、参数数量以及理论计算量
FLOPs
。
Modelsize
(pixels)mAPval
0.5:0.95mAPval
0.5Speed
CPU b1
(ms)Speed
V100 b1
(ms)Speed
V100 b32
(ms)params
(M)FLOPs
@640 (B)YOLOv5n64028.045.7456.30.61.94.5YOLOv5s64037.456.8986.40.97.216.5YOLOv5m64045.464.12248.21.721.249.0YOLOv5l64049.067.343010.12.746.5109.1YOLOv5x64050.768.976612.14.886.7205.7YOLOv5n6128036.054.41538.12.13.24.6YOLOv5s6128044.863.73858.23.612.616.8YOLOv5m6128051.369.388711.16.835.750.0YOLOv5l6128053.771.3178415.810.576.8111.4YOLOv5x6
- TTA1280
153655.0
55.872.7
72.73136
-26.2
-19.4
-140.7
-209.8
-
1 网络结构
关于YOLOv5的网络结构其实网上相关的讲解已经有很多了。网络结构主要由以下几部分组成:
- Backbone:
New CSP-Darknet53 - Neck:
SPPF,New CSP-PAN - Head:
YOLOv3 Head
下面是我根据
yolov5l.yaml
绘制的网络整体结构,YOLOv5针对不同大小(
n
,
s
,
m
,
l
,
x
)的网络整体架构都是一样的,只不过会在每个子模块中采用不同的深度和宽度,分别应对
yaml
文件中的
depth_multiple
和
width_multiple
参数。还需要注意一点,官方除了
n
,
s
,
m
,
l
,
x
版本外还有
n6
,
s6
,
m6
,
l6
,
x6
,区别在于后者是针对更大分辨率的图片比如
1280x1280
,当然结构上也有些差异,后者会下采样64倍,采用4个预测特征层,而前者只会下采样到32倍且采用3个预测特征层。本博文只讨论前者。下面这幅图(
yolov5l
)有点大,大家可以下载下来仔细看一下。

通过和上篇博文讲的YOLOv4对比,其实YOLOv5在Backbone部分没太大变化。但是YOLOv5在
v6.0
版本后相比之前版本有一个很小的改动,把网络的第一层(原来是
Focus
模块)换成了一个
6x6
大小的卷积层。两者在理论上其实等价的,但是对于现有的一些GPU设备(以及相应的优化算法)使用
6x6
大小的卷积层比使用
Focus
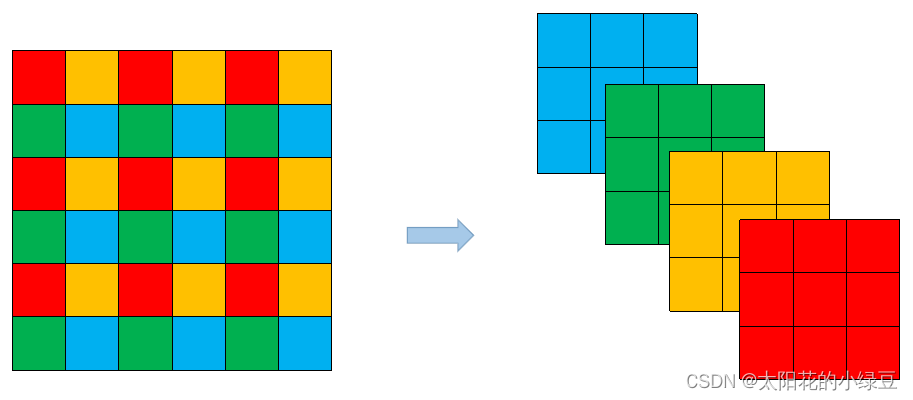
模块更加高效。详情可以参考这个issue #4825。下图是原来的
Focus
模块(和之前
Swin Transformer
中的
Patch Merging
类似),将每个
2x2
的相邻像素划分为一个
patch
,然后将每个
patch
中相同位置(同一颜色)像素给拼在一起就得到了4个
feature map
,然后在接上一个
3x3
大小的卷积层。这和直接使用一个
6x6
大小的卷积层等效。
在Neck部分的变化还是相对较大的,首先是将
SPP
换成成了
SPPF
(
Glenn Jocher
自己设计的),这个改动我个人觉得还是很有意思的,两者的作用是一样的,但后者效率更高。
SPP
结构如下图所示,是将输入并行通过多个不同大小的
MaxPool
,然后做进一步融合,能在一定程度上解决目标多尺度问题。
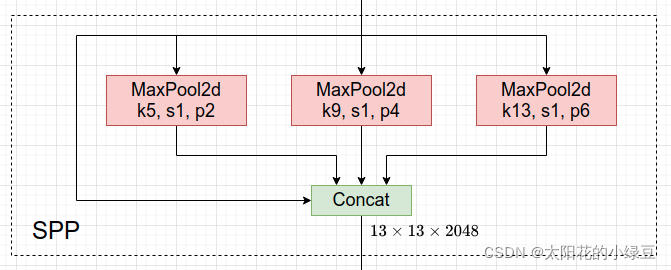
而
SPPF
结构是将输入串行通过多个
5x5
大小的
MaxPool
层,这里需要注意的是串行两个
5x5
大小的
MaxPool
层是和一个
9x9
大小的
MaxPool
层计算结果是一样的,串行三个
5x5
大小的
MaxPool
层是和一个
13x13
大小的
MaxPool
层计算结果是一样的。
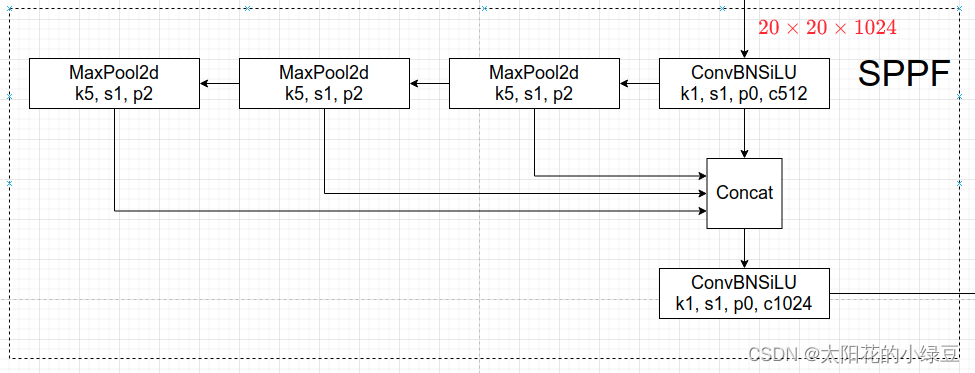
下面做个简单的小实验,对比下
SPP
和
SPPF
的计算结果以及速度,代码如下(注意这里将
SPPF
中最开始和结尾处的
1x1
卷积层给去掉了,只对比含有
MaxPool
的部分):
import time
import torch
import torch.nn as nn

classSPP(nn.Module):def__init__(self):super().__init__()
        self.maxpool1 = nn.MaxPool2d(5,1, padding=2)
        self.maxpool2 = nn.MaxPool2d(9,1, padding=4)
        self.maxpool3 = nn.MaxPool2d(13,1, padding=6)defforward(self, x):
        o1 = self.maxpool1(x)
        o2 = self.maxpool2(x)
        o3 = self.maxpool3(x)return torch.cat([x, o1, o2, o3], dim=1)classSPPF(nn.Module):def__init__(self):super().__init__()
        self.maxpool = nn.MaxPool2d(5,1, padding=2)defforward(self, x):
        o1 = self.maxpool(x)
        o2 = self.maxpool(o1)
        o3 = self.maxpool(o2)return torch.cat([x, o1, o2, o3], dim=1)defmain():
    input_tensor = torch.rand(8,32,16,16)
    spp = SPP()
    sppf = SPPF()
    output1 = spp(input_tensor)
    output2 = sppf(input_tensor)print(torch.equal(output1, output2))

    t_start = time.time()for _ inrange(100):
        spp(input_tensor)print(f"spp time: {time.time() - t_start}")

    t_start = time.time()for _ inrange(100):
        sppf(input_tensor)print(f"sppf time: {time.time() - t_start}")if __name__ =='__main__':
    main()
终端输出:
True
spp time: 0.5373051166534424
sppf time: 0.20780706405639648
通过对比可以发现,两者的计算结果是一模一样的,但
SPPF
比
SPP
计算速度快了不止两倍,快乐翻倍。
在Neck部分另外一个不同点就是
New CSP-PAN
了,在YOLOv4中,Neck的
PAN
结构是没有引入
CSP
结构的,但在YOLOv5中作者在
PAN
结构中加入了
CSP
。详情见上面的网络结构图,每个
C3
模块里都含有
CSP
结构。在Head部分,YOLOv3, v4, v5都是一样的,这里就不讲了。
2 数据增强
在YOLOv5代码里,关于数据增强策略还是挺多的,这里简单罗列部分方法:
- Mosaic,将四张图片拼成一张图片,讲过很多次了

- Copy paste,将部分目标随机的粘贴到图片中,前提是数据要有
segments数据才行,即每个目标的实例分割信息。下面是Copy paste原论文中的示意图。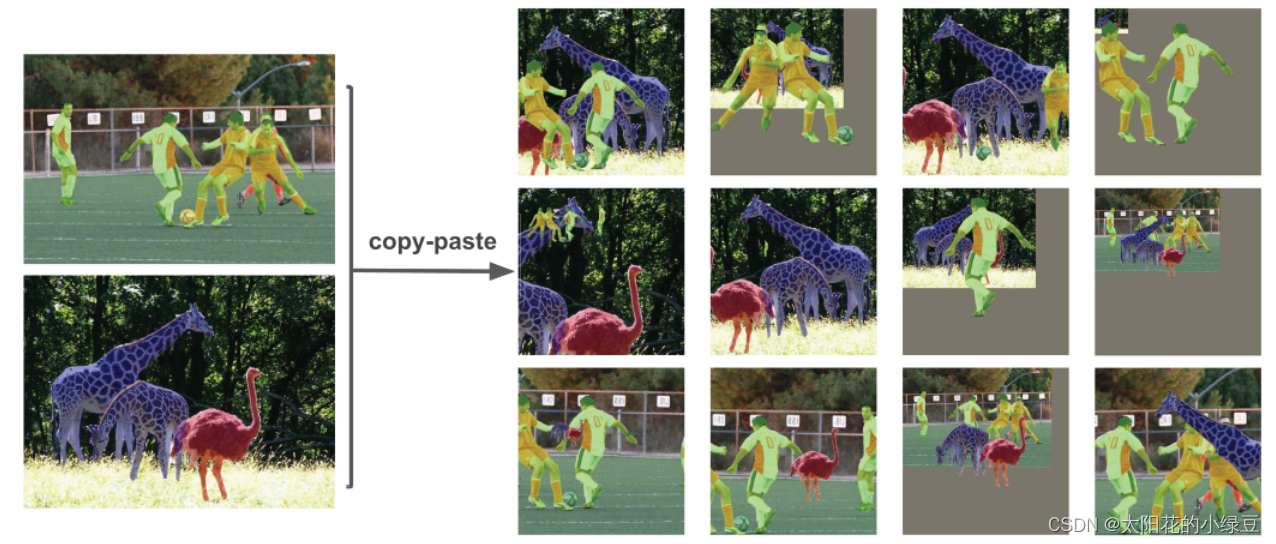
- **Random affine(Rotation, Scale, Translation and Shear)**,随机进行仿射变换,但根据配置文件里的超参数发现只使用了
Scale和Translation即缩放和平移。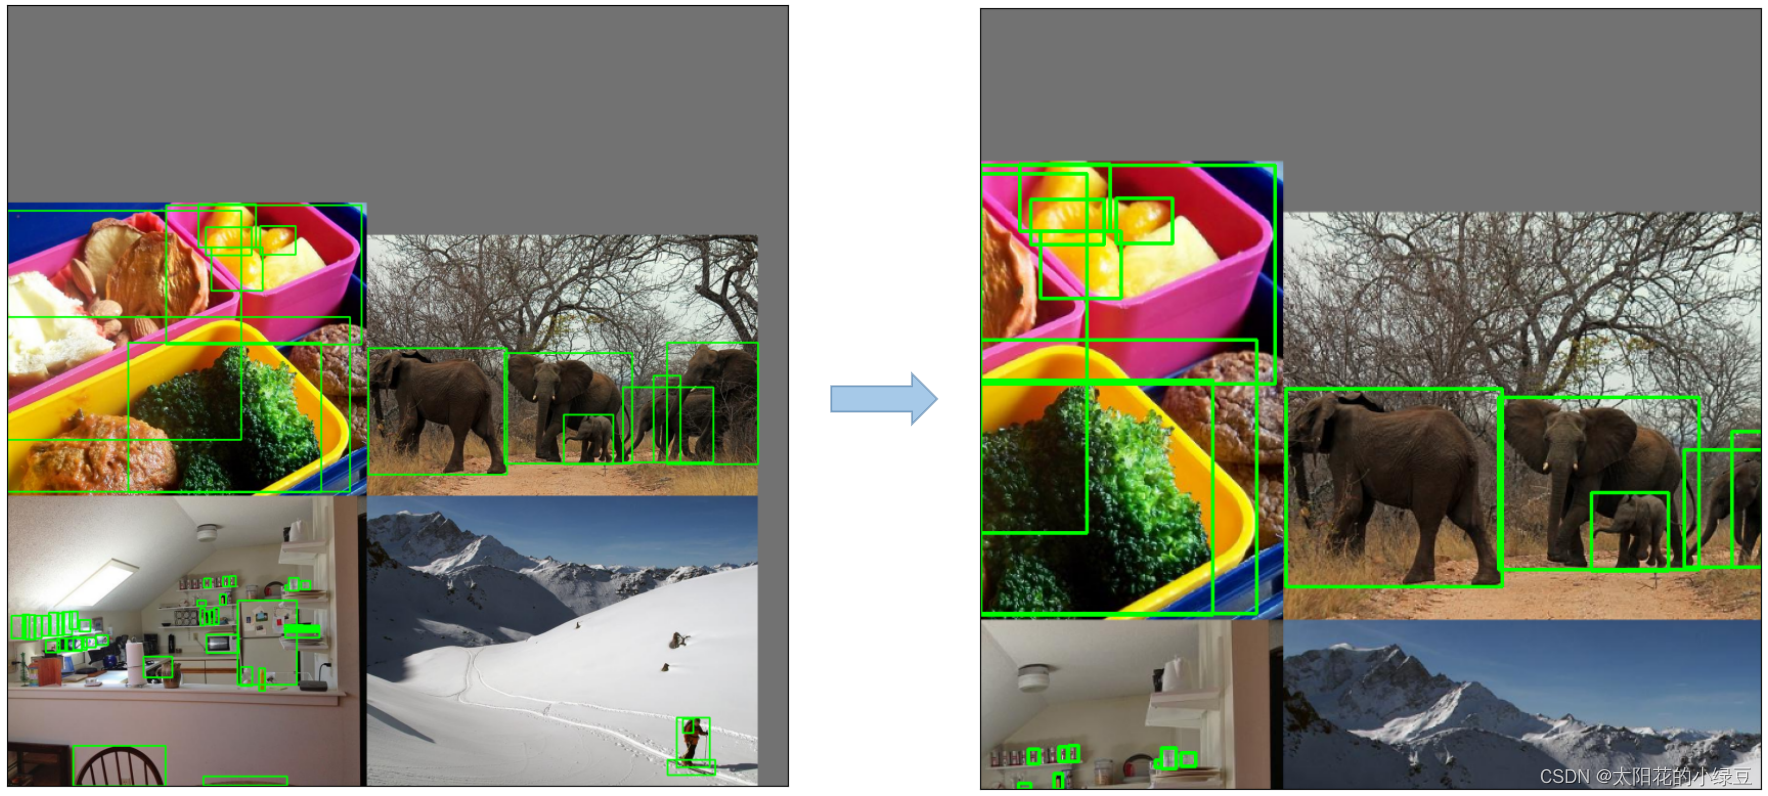
- MixUp,就是将两张图片按照一定的透明度融合在一起,具体有没有用不太清楚,毕竟没有论文,也没有消融实验。代码中只有较大的模型才使用到了
MixUp,而且每次只有10%的概率会使用到。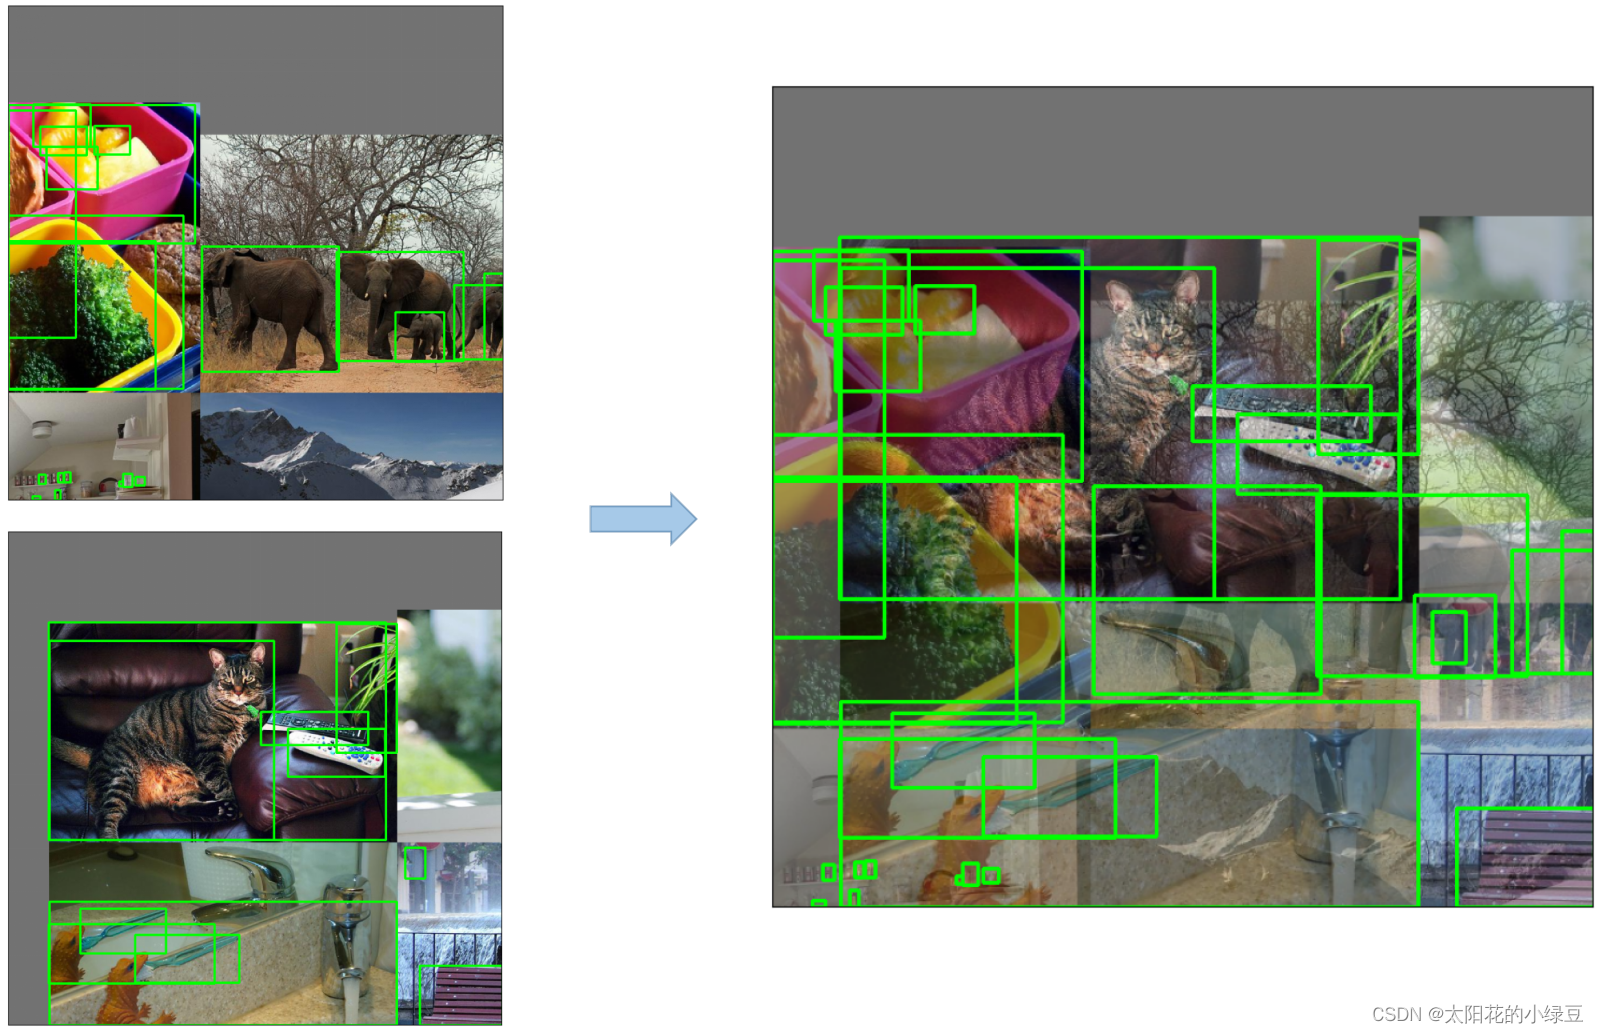
- Albumentations,主要是做些滤波、直方图均衡化以及改变图片质量等等,我看代码里写的只有安装了
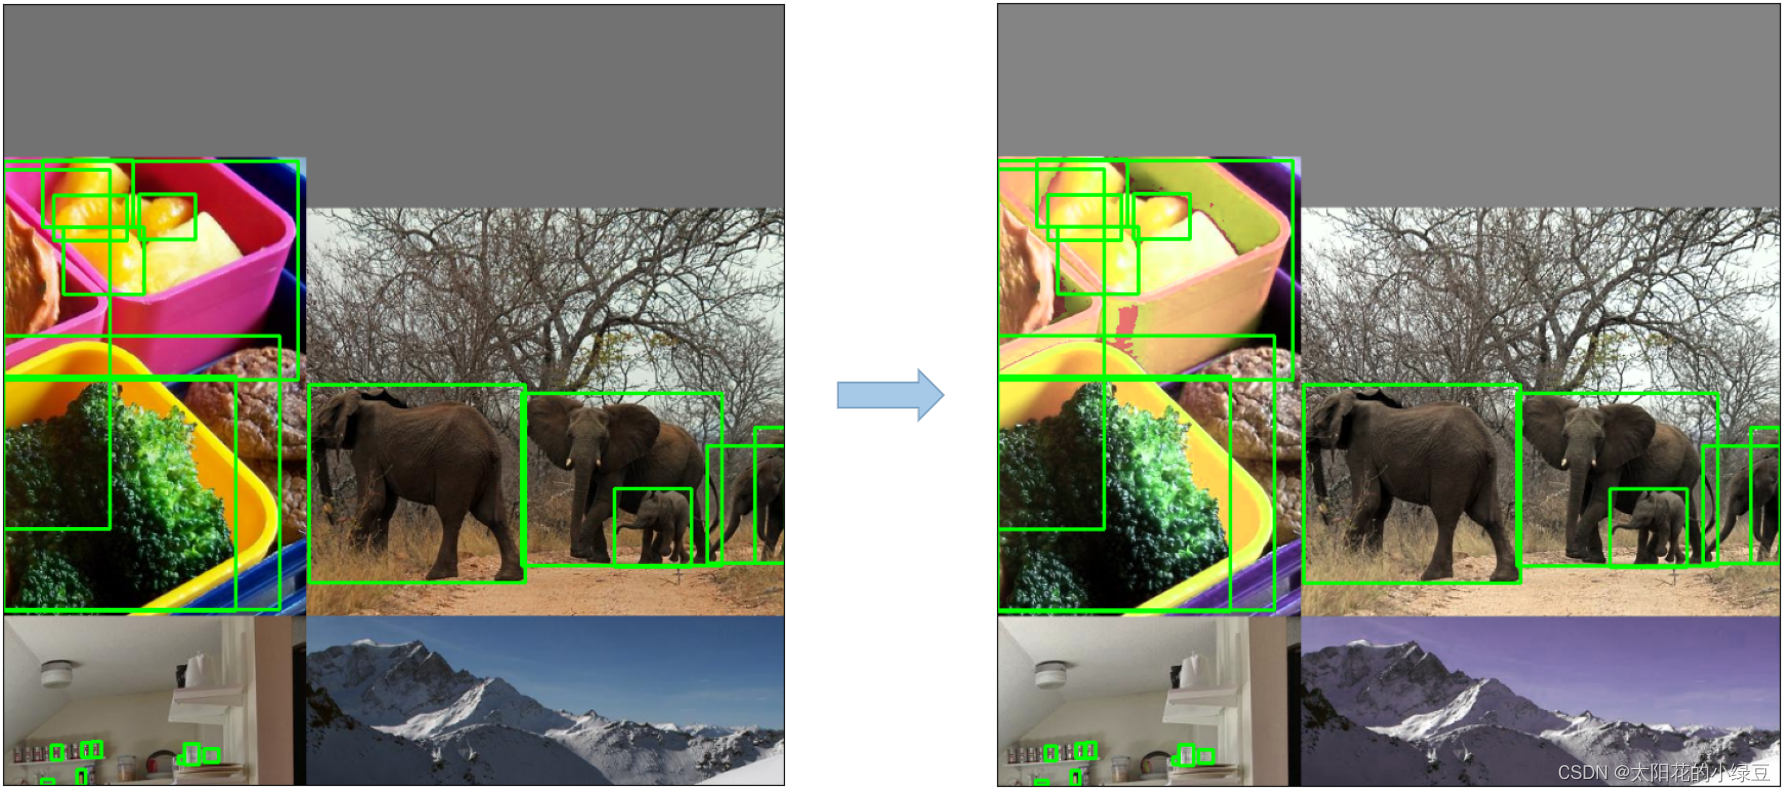
albumentations包才会启用,但在项目的requirements.txt文件中albumentations包是被注释掉了的,所以默认不启用。 - **Augment HSV(Hue, Saturation, Value)**,随机调整色度,饱和度以及明度。
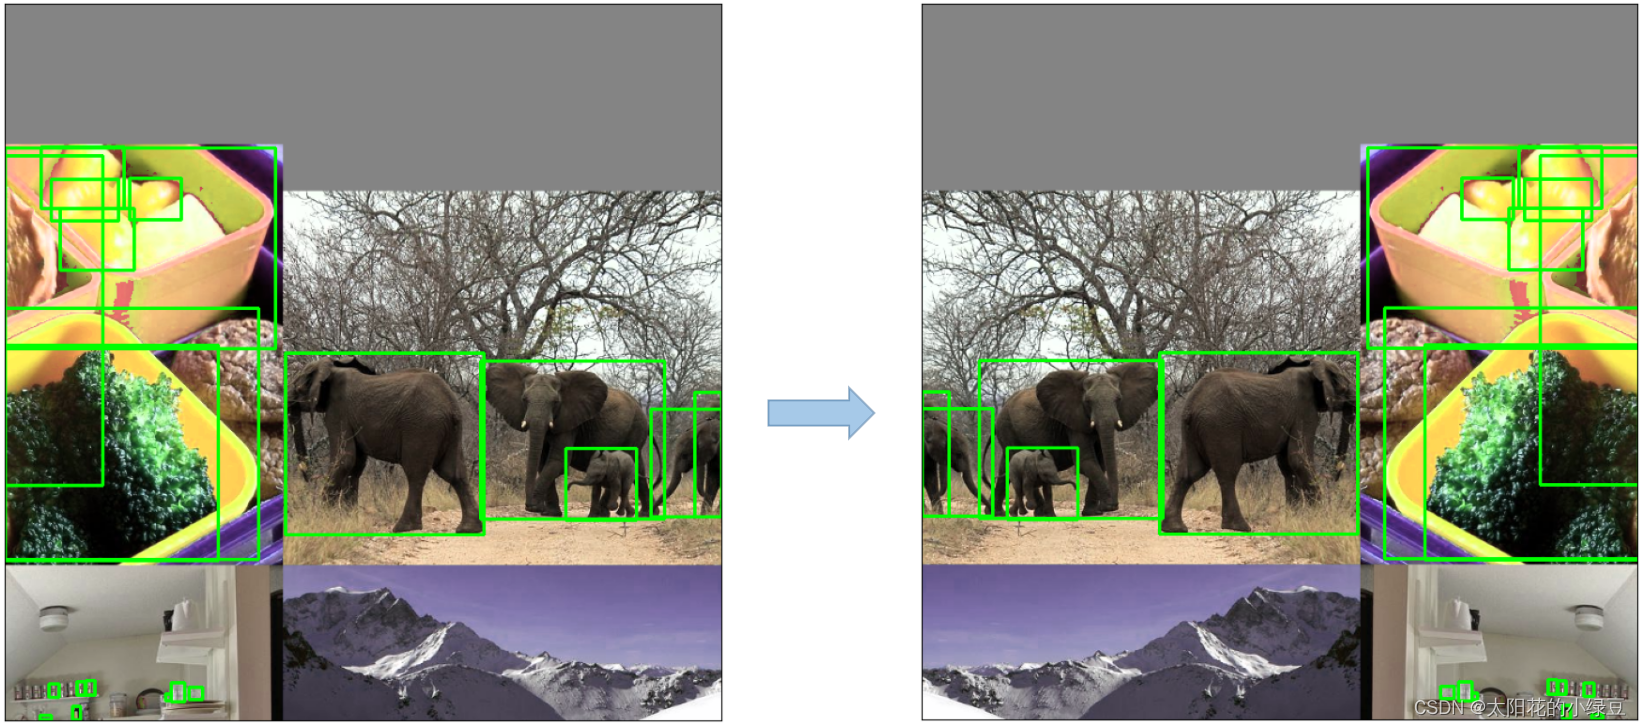
- Random horizontal flip,随机水平翻转
3 训练策略
在YOLOv5源码中使用到了很多训练的策略,这里简单总结几个我注意到的点,还有些没注意到的请大家自己看下源码:
- **Multi-scale training(0.5~1.5x)**,多尺度训练,假设设置输入图片的大小为 640 × 640 640 \times 640 640×640,训练时采用尺寸是在 0.5 × 640 ∼ 1.5 × 640 0.5 \times 640 \sim 1.5 \times 640 0.5×640∼1.5×640之间随机取值,注意取值时取得都是32的整数倍(因为网络会最大下采样32倍)。
- **AutoAnchor(For training custom data)**,训练自己数据集时可以根据自己数据集里的目标进行重新聚类生成Anchors模板。
- Warmup and Cosine LR scheduler,训练前先进行
Warmup热身,然后在采用Cosine学习率下降策略。 - **EMA(Exponential Moving Average)**,可以理解为给训练的参数加了一个动量,让它更新过程更加平滑。
- Mixed precision,混合精度训练,能够减少显存的占用并且加快训练速度,前提是GPU硬件支持。
- Evolve hyper-parameters,超参数优化,没有炼丹经验的人勿碰,保持默认就好。
4 其他
4.1 损失计算
YOLOv5的损失主要由三个部分组成:
Classes loss,分类损失,采用的是
BCE loss,注意只计算正样本的分类损失。Objectness loss,
obj损失,采用的依然是BCE loss,注意这里的obj指的是网络预测的目标边界框与GT Box的CIoU。这里计算的是所有样本的obj损失。Location loss,定位损失,采用的是
CIoU loss,注意只计算正样本的定位损失。L o s s = λ 1 L c l s + λ 2 L o b j + λ 3 L l o c Loss=\lambda_1 L_{cls} + \lambda_2 L_{obj} + \lambda_3 L_{loc}Loss=λ1Lcls+λ2Lobj+λ3Lloc
其中,
λ
1
,
λ
2
,
λ
3
\lambda_1, \lambda_2, \lambda_3
λ1,λ2,λ3为平衡系数。
4.2 平衡不同尺度的损失
这里是指针对三个预测特征层(
P3, P4, P5
)上的
obj
损失采用不同的权重。在源码中,针对预测小目标的预测特征层(
P3
)采用的权重是
4.0
,针对预测中等目标的预测特征层(
P4
)采用的权重是
1.0
,针对预测大目标的预测特征层(
P5
)采用的权重是
0.4
,作者说这是针对
COCO
数据集设置的超参数。
L
o
b
j
=
4.0
⋅
L
o
b
j
s
m
a
l
l
+
1.0
⋅
L
o
b
j
m
e
d
i
u
m
+
0.4
⋅
L
o
b
j
l
a
r
g
e
L_{obj} = 4.0 \cdot L_{obj}^{small} + 1.0 \cdot L_{obj}^{medium} + 0.4 \cdot L_{obj}^{large}
Lobj=4.0⋅Lobjsmall+1.0⋅Lobjmedium+0.4⋅Lobjlarge
4.3 消除Grid敏感度
在上篇文章YOLOv4中有提到过,主要是调整预测目标中心点相对Grid网格的左上角偏移量。下图是YOLOv2,v3的计算公式。

其中:
t x t_x tx是网络预测的目标中心 x x x坐标偏移量(相对于网格的左上角)t y t_y ty是网络预测的目标中心 y y y坐标偏移量(相对于网格的左上角)c x c_x cx是对应网格左上角的 x x x坐标c y c_y cy是对应网格左上角的 y y y坐标σ \sigma σ是```Sigmoid```激活函数,将预测的偏移量限制在0到1之间,即预测的中心点不会超出对应的```Grid Cell```区域
关于预测目标中心点相对Grid网格左上角
(
c
x
,
c
y
)
(c_x, c_y)
(cx,cy)偏移量为
σ
(
t
x
)
,
σ
(
t
y
)
\sigma(t_x), \sigma(t_y)
σ(tx),σ(ty)。YOLOv4的作者认为这样做不太合理,比如当真实目标中心点非常靠近网格的左上角点(
σ
(
t
x
)
\sigma(t_x)
σ(tx)和
σ
(
t
y
)
\sigma(t_y)
σ(ty)应该趋近与0)或者右下角点(
σ
(
t
x
)
\sigma(t_x)
σ(tx)和
σ
(
t
y
)
\sigma(t_y)
σ(ty)应该趋近与1)时,网络的预测值需要负无穷或者正无穷时才能取到,而这种很极端的值网络一般无法达到。为了解决这个问题,作者对偏移量进行了缩放从原来的
(
0
,
1
)
(0, 1)
(0,1)缩放到
(
−
0.5
,
1.5
)
(-0.5, 1.5)
(−0.5,1.5)这样网络预测的偏移量就能很方便达到0或1,故最终预测的目标中心点
b
x
,
b
y
b_x, b_y
bx,by的计算公式为:
b
x
=
(
2
⋅
σ
(
t
x
)
−
0.5
)
+
c
x
b
y
=
(
2
⋅
σ
(
t
y
)
−
0.5
)
+
c
y
b_x = (2 \cdot \sigma(t_x) - 0.5) + c_x \\ b_y = (2 \cdot \sigma(t_y) - 0.5) + c_y
bx=(2⋅σ(tx)−0.5)+cxby=(2⋅σ(ty)−0.5)+cy
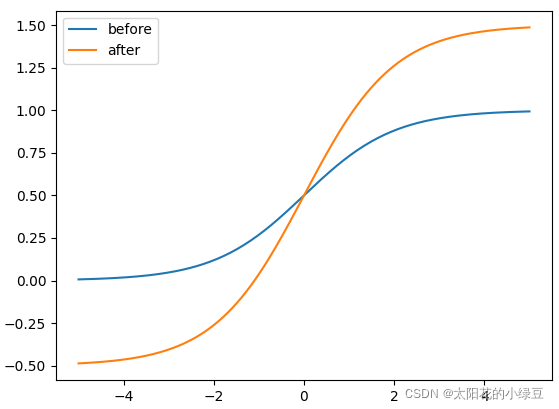
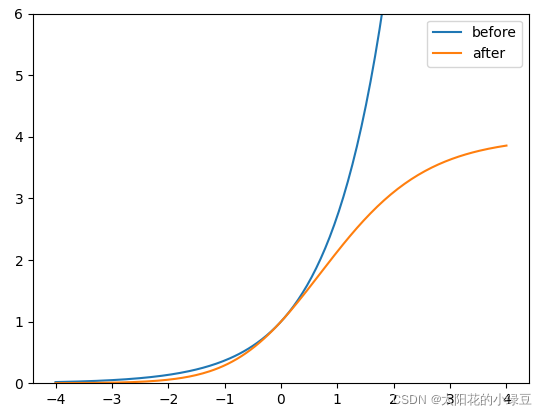
下图是我绘制的
    y


    =


    σ


    (


    x


    )


   y = \sigma(x)


y=σ(x)对应
before
曲线和
    y


    =


    2


    ⋅


    σ


    (


    x


    )


    −


    0.5


   y = 2 \cdot \sigma(x) - 0.5


y=2⋅σ(x)−0.5对应
after
曲线,很明显通过引入缩放系数scale以后,
    y


   y


y对


    x


   x


x更敏感了,且偏移的范围由原来的


    (


    0


    ,


    1


    )


   (0, 1)


(0,1)调整到了


    (


    −


    0.5


    ,


    1.5


    )


   (-0.5, 1.5)


(−0.5,1.5)。
在YOLOv5中除了调整预测Anchor相对Grid网格左上角
(
c
x
,
c
y
)
(c_x, c_y)
(cx,cy)偏移量以外,还调整了预测目标高宽的计算公式,之前是:
b
w
=
p
w
⋅
e
t
w
b
h
=
p
h
⋅
e
t
h
b_w = p_w \cdot e^{t_w} \\ b_h = p_h \cdot e^{t_h}
bw=pw⋅etwbh=ph⋅eth
在YOLOv5调整为:
b
w
=
p
w
⋅
(
2
⋅
σ
(
t
w
)
)
2
b
h
=
p
h
⋅
(
2
⋅
σ
(
t
h
)
)
2
b_w = p_w \cdot (2 \cdot \sigma(t_w))^2 \\ b_h = p_h \cdot (2 \cdot \sigma(t_h))^2
bw=pw⋅(2⋅σ(tw))2bh=ph⋅(2⋅σ(th))2
作者
Glenn Jocher
的原话如下,也可以参考issue #471:
The original yolo/darknet box equations have a serious flaw. Width and Height are completely unbounded as they are simply out=exp(in), which is dangerous, as it can lead to runaway gradients, instabilities, NaN losses and ultimately a complete loss of training.
作者的大致意思是,原来的计算公式并没有对预测目标宽高做限制,这样可能出现梯度爆炸,训练不稳定等问题。下图是修改前
    y


    =


     e


     x


   y = e^x


y=ex和修改后


    y


    =


    (


    2


    ⋅


    σ


    (


    x


    )


     )


     2


   y = (2 \cdot \sigma(x))^2


y=(2⋅σ(x))2(相对Anchor宽高的倍率因子)的变化曲线, 很明显调整后倍率因子被限制在


    (


    0


    ,


    4


    )


   (0, 4)


(0,4)之间。
4.4 匹配正样本(Build Targets)
之前在YOLOv4介绍中有讲过该部分内容,其实YOLOv5也差不多。主要的区别在于
GT Box
与
Anchor Templates
模板的匹配方式。在YOLOv4中是直接将每个
GT Box
与对应的
Anchor Templates
模板计算
IoU
,只要
IoU
大于设定的阈值就算匹配成功。但在YOLOv5中,作者先去计算每个
GT Box
与对应的
Anchor Templates
模板的高宽比例,即:
r
w
=
w
g
t
/
w
a
t
r
h
=
h
g
t
/
h
a
t
r_w = w_{gt} / w_{at} \\ r_h = h_{gt} / h_{at} \\
rw=wgt/watrh=hgt/hat
然后统计这些比例和它们倒数之间的最大值,这里可以理解成计算
GT Box
和
Anchor Templates
分别在宽度以及高度方向的最大差异(当相等的时候比例为1,差异最小):
r
w
m
a
x
=
m
a
x
(
r
w
,
1
/
r
w
)
r
h
m
a
x
=
m
a
x
(
r
h
,
1
/
r
h
)
r_w^{max} = max(r_w, 1 / r_w) \\ r_h^{max} = max(r_h, 1 / r_h)
rwmax=max(rw,1/rw)rhmax=max(rh,1/rh)
接着统计
r
w
m
a
x
r_w^{max}
rwmax和
r
h
m
a
x
r_h^{max}
rhmax之间的最大值,即宽度和高度方向差异最大的值:
r
m
a
x
=
m
a
x
(
r
w
m
a
x
,
r
h
m
a
x
)
r^{max} = max(r_w^{max}, r_h^{max})
rmax=max(rwmax,rhmax)
如果
GT Box
和对应的
Anchor Template
的
     r


      m


      a


      x


   r^{max}


rmax小于阈值
anchor_t
(在源码中默认设置为
4.0
),即
GT Box
和对应的
Anchor Template
的高、宽比例相差不算太大,则将
GT Box
分配给该
Anchor Template
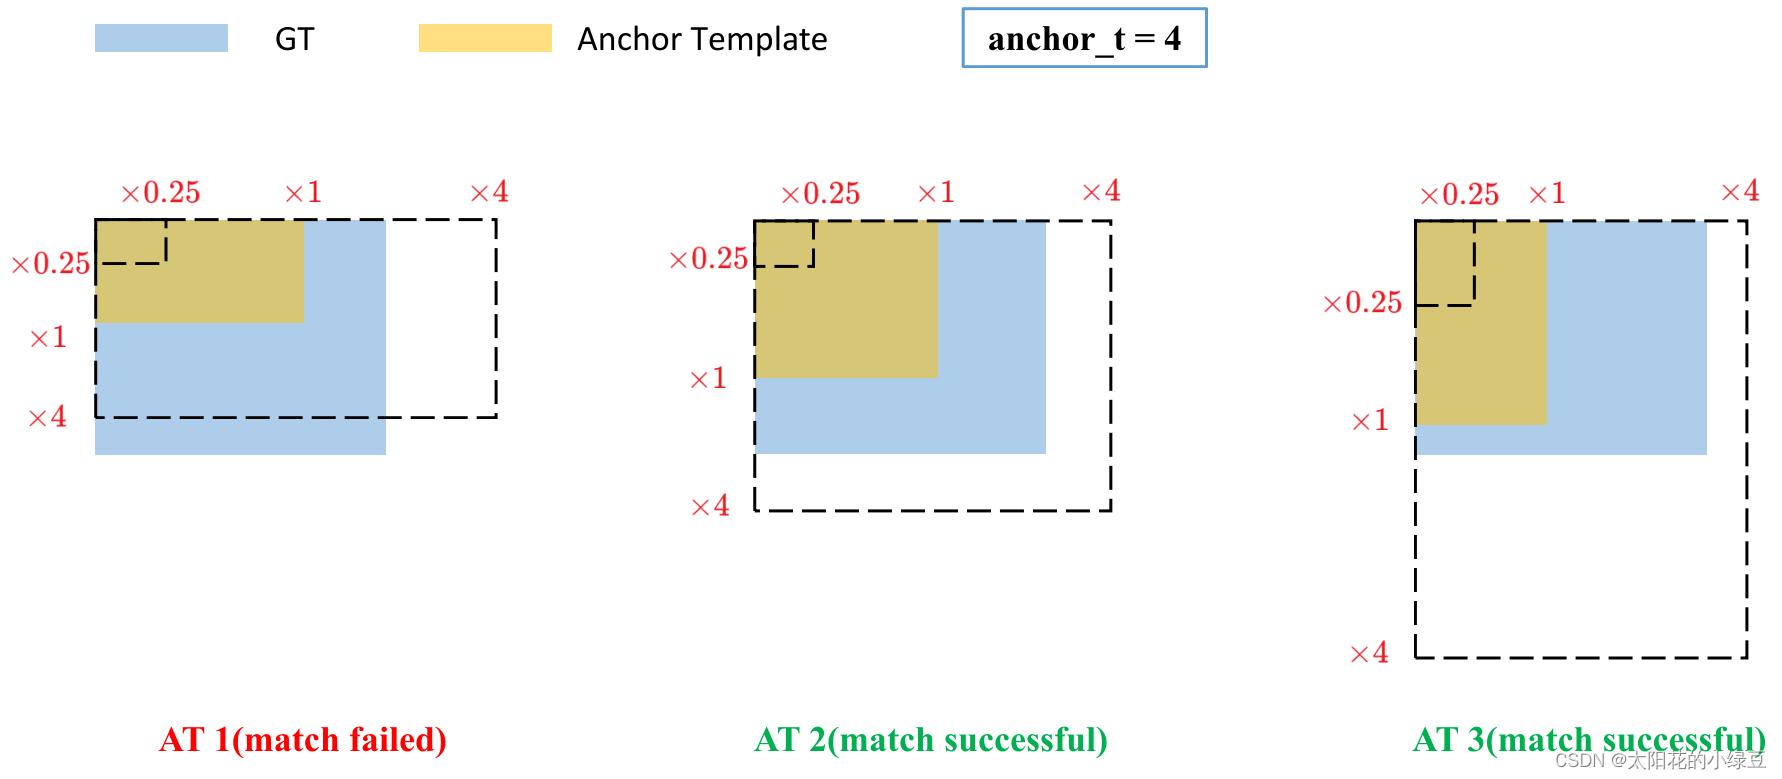
模板。为了方便大家理解,可以看下我画的图。假设对某个
GT Box
而言,其实只要
GT Box
满足在某个
Anchor Template
宽和高的
    ×


    0.25


   \times 0.25


×0.25倍和


    ×


    4.0


   \times 4.0


×4.0倍之间就算匹配成功。
剩下的步骤和YOLOv4中一致:
- 将
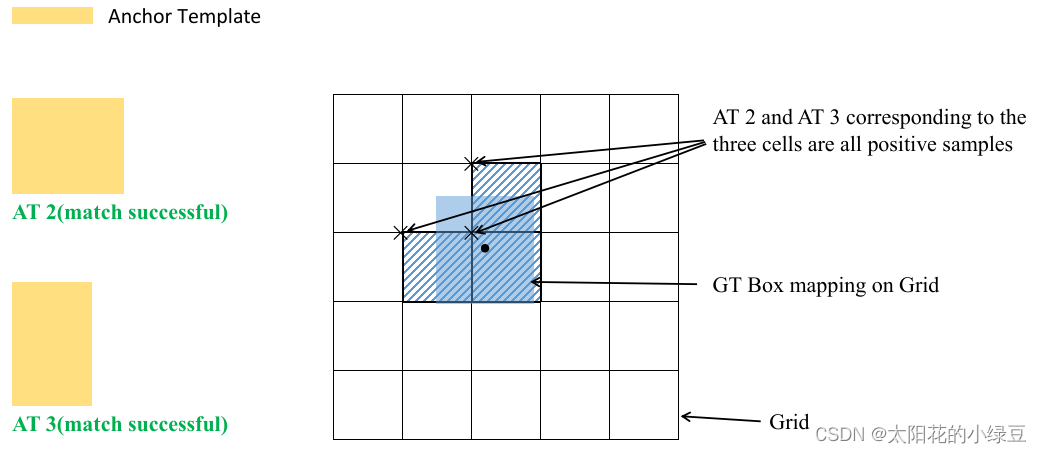
GT投影到对应预测特征层上,根据GT的中心点定位到对应Cell,注意图中有三个对应的Cell。因为网络预测中心点的偏移范围已经调整到了 ( − 0.5 , 1.5 ) (-0.5, 1.5) (−0.5,1.5),所以按理说只要Grid Cell左上角点距离GT中心点在 ( − 0.5 , 1.5 ) (−0.5,1.5) (−0.5,1.5)范围内它们对应的Anchor都能回归到GT的位置处。这样会让正样本的数量得到大量的扩充。 - 则这三个
Cell对应的AT2和AT3都为正样本。
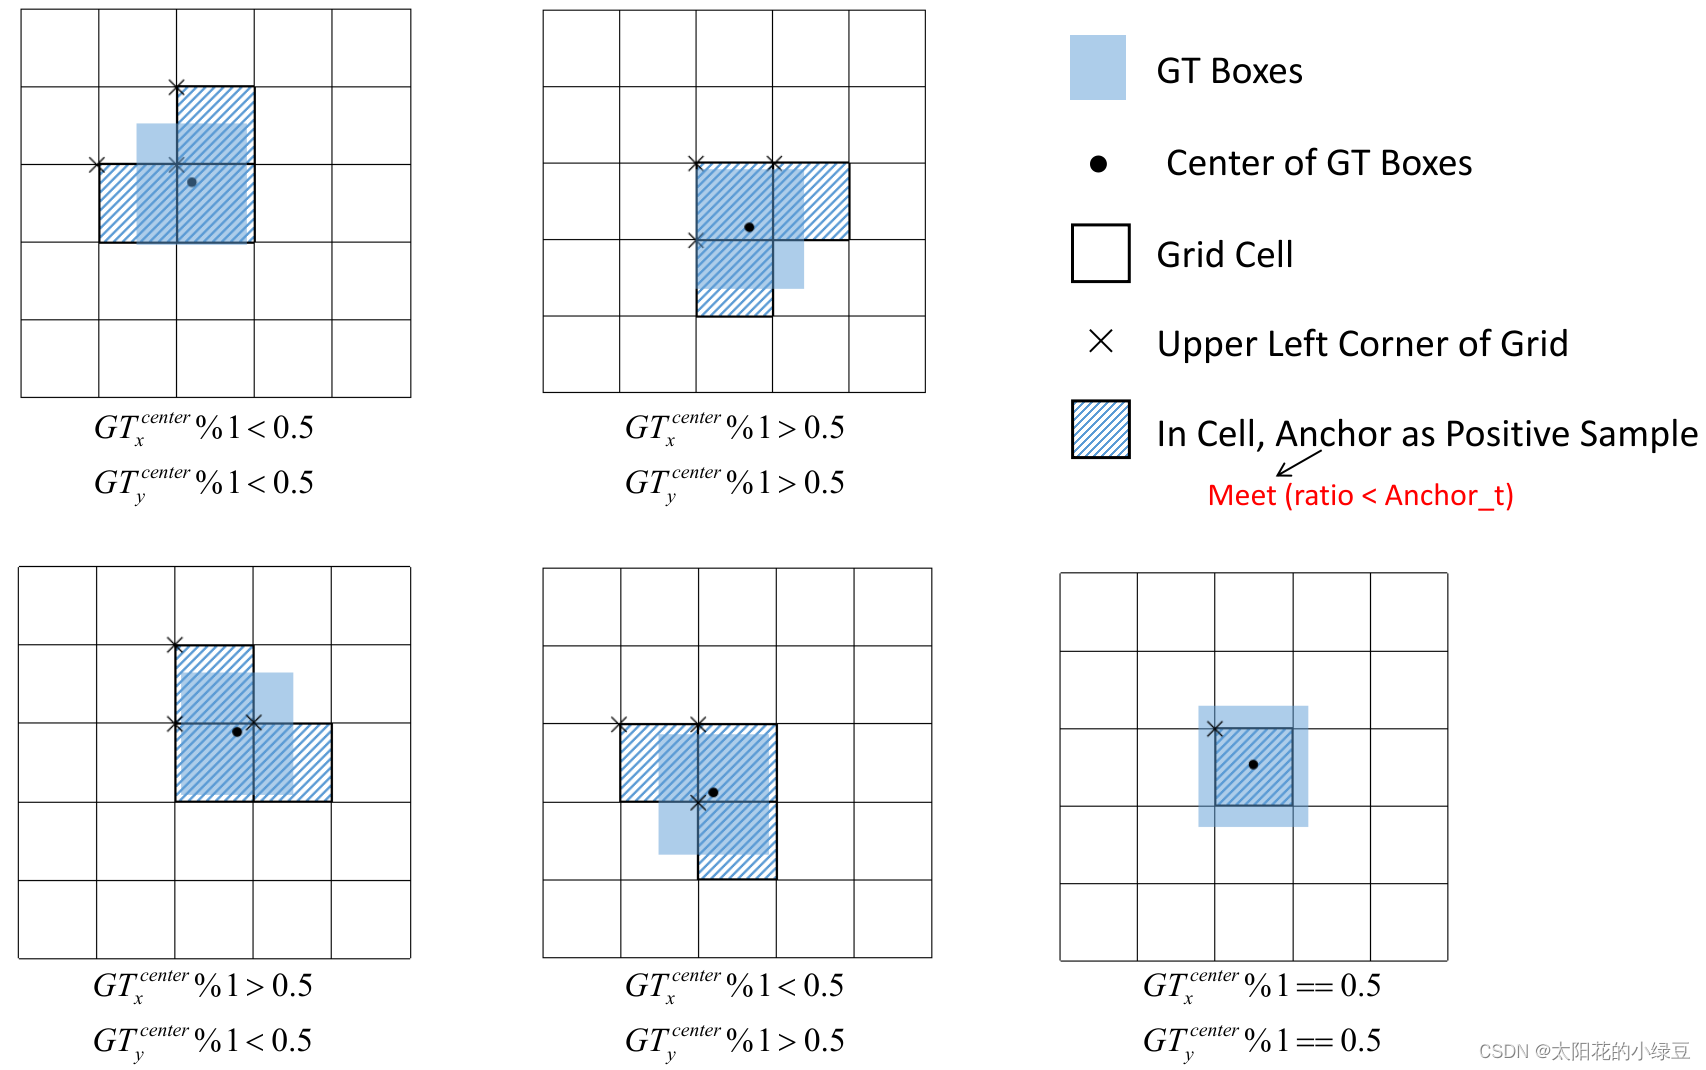
还需要注意的是,YOLOv5源码中扩展
Cell
时只会往上、下、左、右四个方向扩展,不会往左上、右上、左下、右下方向扩展。下面又给出了一些根据
G
T
x
c
e
n
t
e
r
,
G
T
y
c
e
n
t
e
r
GT_x^{center}, GT_y^{center}
GTxcenter,GTycenter的位置扩展的一些
Cell
案例,其中
%1
表示取余并保留小数部分。
到此,YOLOv5相关的内容基本上都分析完了。当然由于个人原因,肯定还有一些细节被我忽略掉了,也建议大家自己看看源码,收获肯定会更多。
版权归原作者 太阳花的小绿豆 所有, 如有侵权,请联系我们删除。